看 Code 與不看 Code?在 Vibe Engineering 時代的難題
Vibe engineering 是一種由人類定義意圖、約束與驗證迴路,再讓 coding agents 大量執行實作的開發方式。它帶來的新難題是:當 AI 產生程式碼的速度遠超人類閱讀能力,我們還需要看多少程式碼,才能對交付結果負責?
這幾天看到《Clean Code》作者 Uncle Bob(Robert C. Martin)的貼文時,我第一個反應其實是:「等一下,連最講究 Clean Code 的大師都叫我們不要看 code 了?」這個標題實在太香了,但把整串討論與背景資料看完後,我發現真正的難題藏在別處:與其糾結「看或不看」這個二選一的信仰,更該問的是我們準備拿什麼證據,來取代原本那雙眼睛。
當《Clean Code》作者說他不看 Code
事情的起因是 2026 年 7 月,Uncle Bob 在 Ori Pomerantz 的 X 貼文 下寫了一段回覆。他提到自己現在刻意不讀 coding agents 寫出來的實作程式碼,因為如果每一行都要人工核對,agent 帶來的生產力效益就會被抵銷光光。
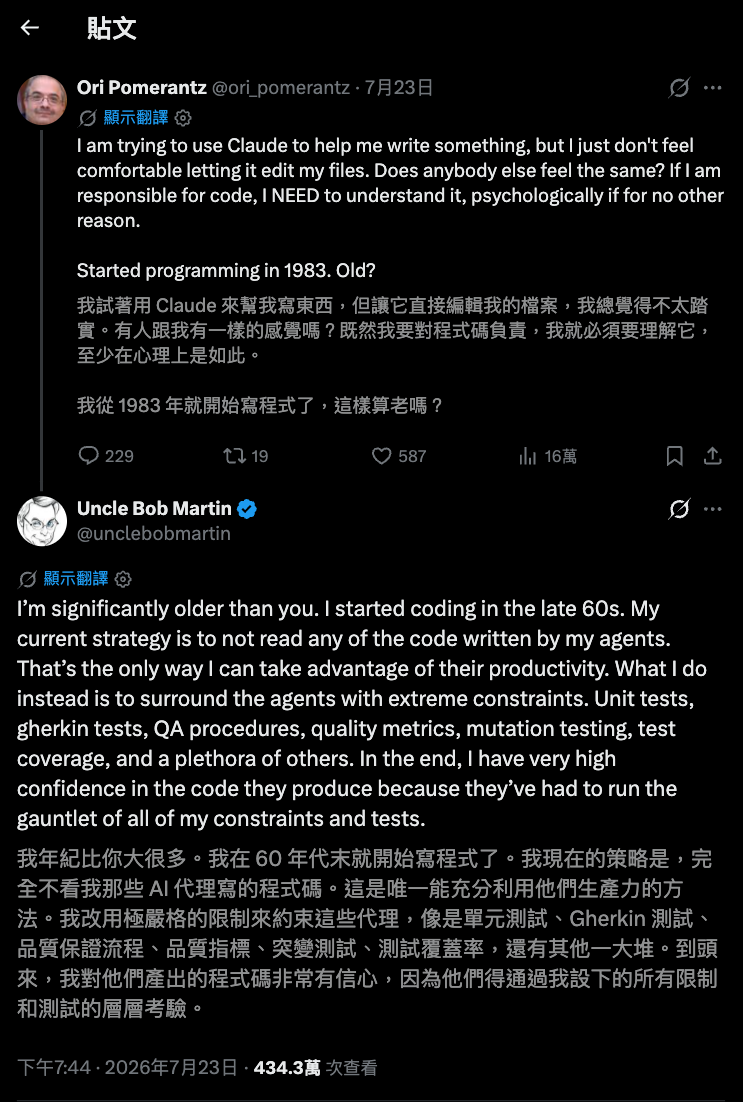
順帶一提,兩位前輩開場還先互報年資:一位說自己 1983 年入行、問這樣算老嗎,另一位直接掏出 60 年代末的資歷反壓回去。笑死。光這個畫面就值得截圖收藏。
這句話由推廣程式碼潔癖幾十年的大師說出口,戲劇效果直接拉滿。但如果你只看到這裡就把《Clean Code》拿去墊便當,可能就中了標題黨的招。他在同一則回覆裡接著強調,自己之所以敢不讀程式碼,是因為他在 agent 外面套了一整套極為嚴苛的關卡:單元測試、Gherkin 驗收測試、QA procedures、覆蓋率與複雜度指標,甚至包括 mutation testing(變異測試)。他把這套讓 agent 自動反覆修正、直到通過所有檢查的過程,形容為 run the gauntlet(通過嚴酷考驗)。
他在後續補充中提到,連 unit tests 和 QA 手續本身也是由 agent 產生的。他不審查 unit tests,但會依據任務的關鍵程度(criticality)抽查或完整檢查 Gherkin 與 QA 手續,並定期親自做手動測試。(註:由於部分後續回覆在 X 上尚未找到獨立連結,上述細節主要透過 ExplainX 的整理 與 Rapha Moura 的文章 交叉比對意譯。)
其實早在 2026 年 4 月,Uncle Bob 在 Wookash Podcast 的提問 下就有過類似宣示。當時他直接寫下「Humans are slow at code」,主張人類在 AI 時代應該轉向更高層的管理,關注測試覆蓋率、模組耦合度、圈複雜度(cyclomatic complexity)與 mutation score。
你看得出其中的差別嗎?Uncle Bob 並沒有放棄品質,他真正在做的是把原本由人類眼睛負責的檢查,轉化為機械式的自動化約束。
不過,把希望全押在測試關卡上真的萬無一失嗎?在急著把 code review 丟進垃圾桶之前,我們得先整理一下大家口中常用的這幾個詞。
先把 Vibe Coding、Agentic Programming、Vibe Engineering 三個詞拆開
現在社群上只要提到用 AI 寫程式,很多人就會隨手貼上 vibe coding 的標籤。但如果把所有 AI 輔助開發都混為一談,後續的工程討論只會變成雞同鴨講。
第一個詞是 Vibe Coding。Andrej Karpathy 在 2025 年 2 月的貼文 中首次提出了這個概念。他當時描述的是一種完全「忘記 code 存在」的狀態:總是按 Accept All、不看 diff、遇到報錯就把錯誤訊息原封不動貼回給模型,甚至任由 AI 進行隨機修改直到程式能跑為止。Karpathy 自己也明確補充,這種極端放手的方式主要適用於週末隨手做做、壞了也無所謂的拋棄式專案(throwaway projects)。
第二個詞是 Agentic Programming。Martin Fowler 在其專欄文章 中提出了這個區分。他認為在 agentic programming 模式下,雖然人類不再親手輸入大部分程式碼,但工程師依然深刻關心系統架構與程式碼品質。人類從打字員轉變為監督者,繼續審視 code review、測試結果與各類監測指標。
第三個詞是 Vibe Engineering。Simon Willison 在 2025 年 10 月提出了 vibe engineering 這個名稱,用來填補 vibe coding 另一端的專業空缺。他強調資深工程師利用 LLM 飛速產出時,依然必須對正式環境(production)的軟體負責。這包括自動化測試、事前規劃、文件紀錄、版本控制、預覽環境與 code review。Willison 在 2026 年的更新中也坦承,Agentic Engineering 未來可能成為更通行的名稱。
如果用日常叫外送來打個比方:vibe coding 就像只看美食照片下單,只要送來能吃就不管廚房怎麼弄;agentic programming 會去檢查餐廳的衛生評鑑與食材成分;而 vibe engineering 還要規劃完整的食安檢驗、動線控管,並在顧客吃壞肚子時有能力進行溯源與賠償。
在本文中,我所指的 vibe engineering 有個更具體的工作定義:人類工程師主要負責定義意圖、邊界、風險與驗證迴路,讓 agent 執行大量實作;人類則依據證據強度,決定審視程式碼的深度。
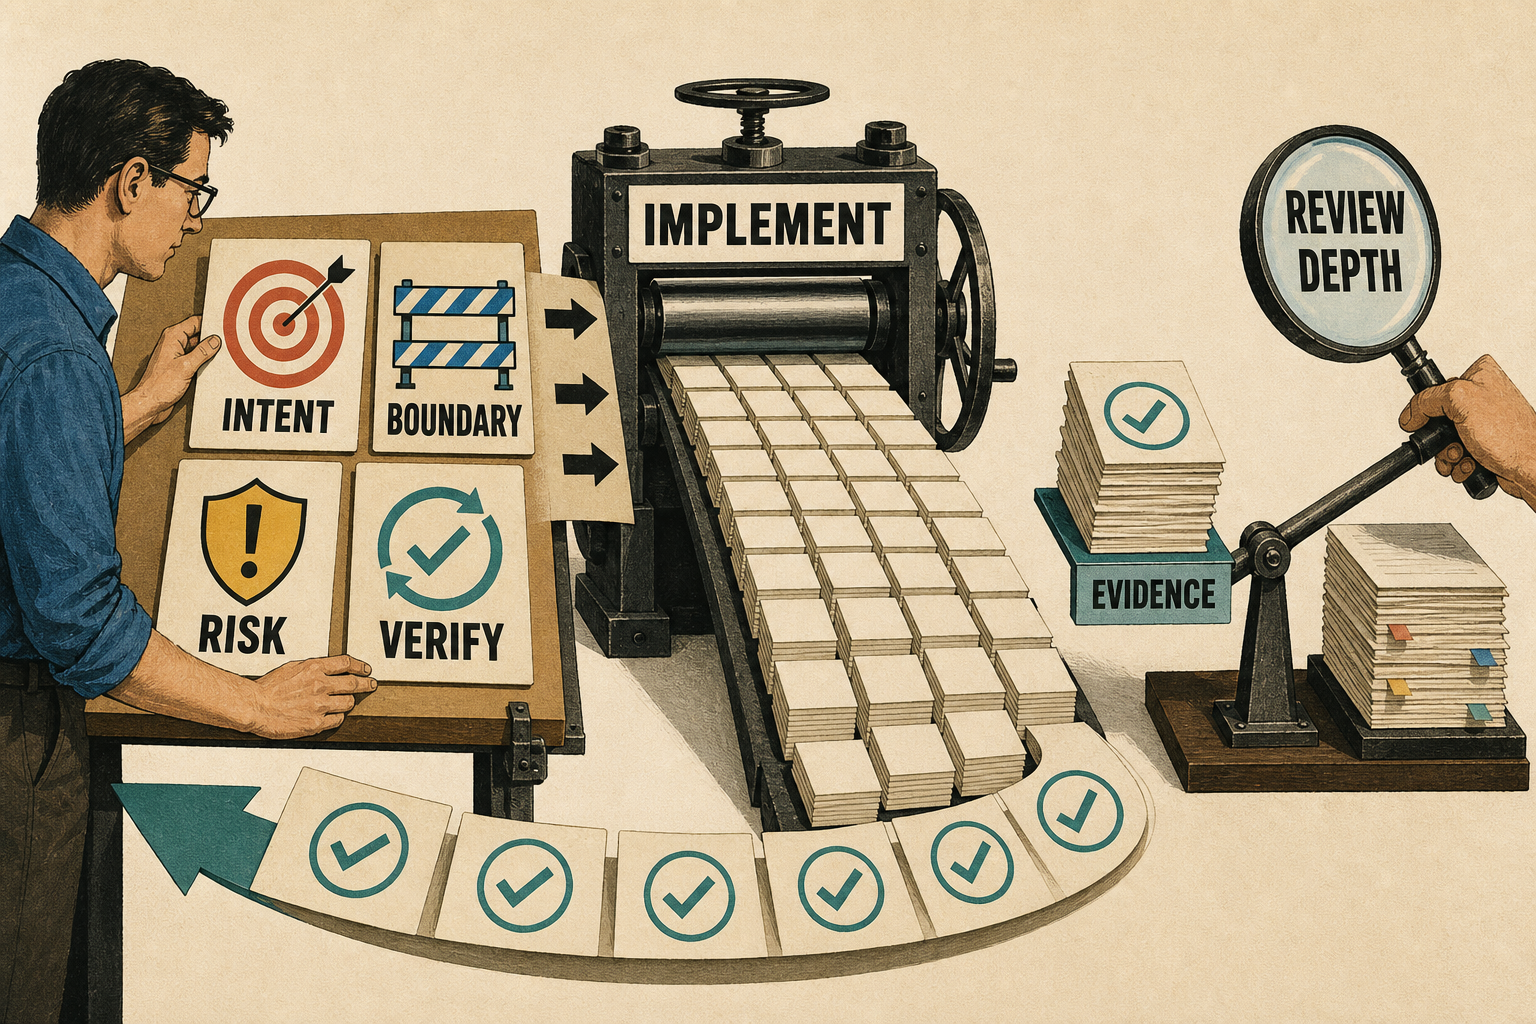
重點來了:既然我們依然要對 production 負責,為什麼「逐行看程式碼」這道傳統防線會開始動搖?
我們以前為什麼要看 Code
回想一下在 AI 普及之前,我們團隊為什麼要強制執行 Code Review?
很多人以為 code review 只是為了「抓 bug」,但這其實只佔了它功能的一小部分。傳統的 code review 更像是一套多功能的團隊健康機制,同時承擔了五種不同的職責:
- 正確性與安全性:尋找邏輯漏洞、邊界條件遺漏、記憶體洩漏與潛在的安全風險。
- 架構與可維護性:檢查模組耦合、Naming 是否清楚、未來維護者能否讀懂。
- 共享心智模型(Shared Mental Model):讓團隊成員知道其他人最近修改了什麼,保持對 codebase 的整體熟悉度。
- 知識傳承與 Mentoring:資深工程師透過評語傳授經驗,新人透過閱讀學習團隊的實務慣例。
- 責任與決策紀錄:在版本控制歷史中留下記錄,證明這段變更曾經被另一個人類思考並批准過。
這就像機場的安檢流程。安檢 X 光機(自動化測試)可以快速掃描出違禁金屬,但安檢現場依然需要人工確認身份、處理例外狀況、評估異常行為,並在出事時承擔責任。
自動化測試主要提供的是「行為正確」的證據,它很難自動接手知識傳承、架構審美與團隊默契建立等社會性功能。著名的電腦科學家 Grady Booch 在針對 Uncle Bob 的討論中 就指出,覆蓋率等指標雖然能提高對功能的信心,卻無法單獨排除潛在漏洞、死碼(dead code)、未來可讀性喪失與架構拆解不當的問題。
既然 code review 承載了這麼多重要功能,為什麼大家現在會迫切地想尋求替代方案?
為什麼逐行看 Code 開始撐不住
答案很現實:AI 產出程式碼的速度,已經徹底壓垮了人類大腦的閱讀頻寬。
想像一下,工廠的生產線輸送帶速度突然提升了十倍,但品管員依然只有兩隻眼睛。這時會發生什麼事?
當 agent 在幾秒鐘內吐出上千行修改,傳統的拉 PR、非同步 Code Review 流程立刻就會變成整個開發週期中最嚴重的堵塞瓶頸。Thoughtworks 在一系列關於 AI 時代 code quality 的探討 中就觀察到,一波波大量湧入的 AI 變更,正在讓傳統 PR review 陷入嚴重的疲勞(review fatigue)。
面對海量的 diff,你以為人類工程師會「更認真看」嗎?現實中常見的反應,是精神疲勞後快速滾動頁面,最後隨手點下 LGTM。
這種「假裝看過」的 code review,往往比公開承認「我沒看實作,但我信任測試」更加危險。因為它製造了一種控制的虛假安全感,讓你以為有人把關,實際上大家只是在過場走儀式。
這就是 Uncle Bob 試圖解決的困境:與其讓人類在疲勞中進行品質滑坡的偽審查,不如把注意力抽離程式碼細節,建立一套極度嚴格的自動化測試關卡。
Uncle Bob 把信任搬到哪裡
那麼,Uncle Bob 口中那套足以取代人類眼睛的 Test Gauntlet,究竟包含了哪些東西?我們把它拆開來看,每一道關卡能證明什麼、又有哪些盲點:
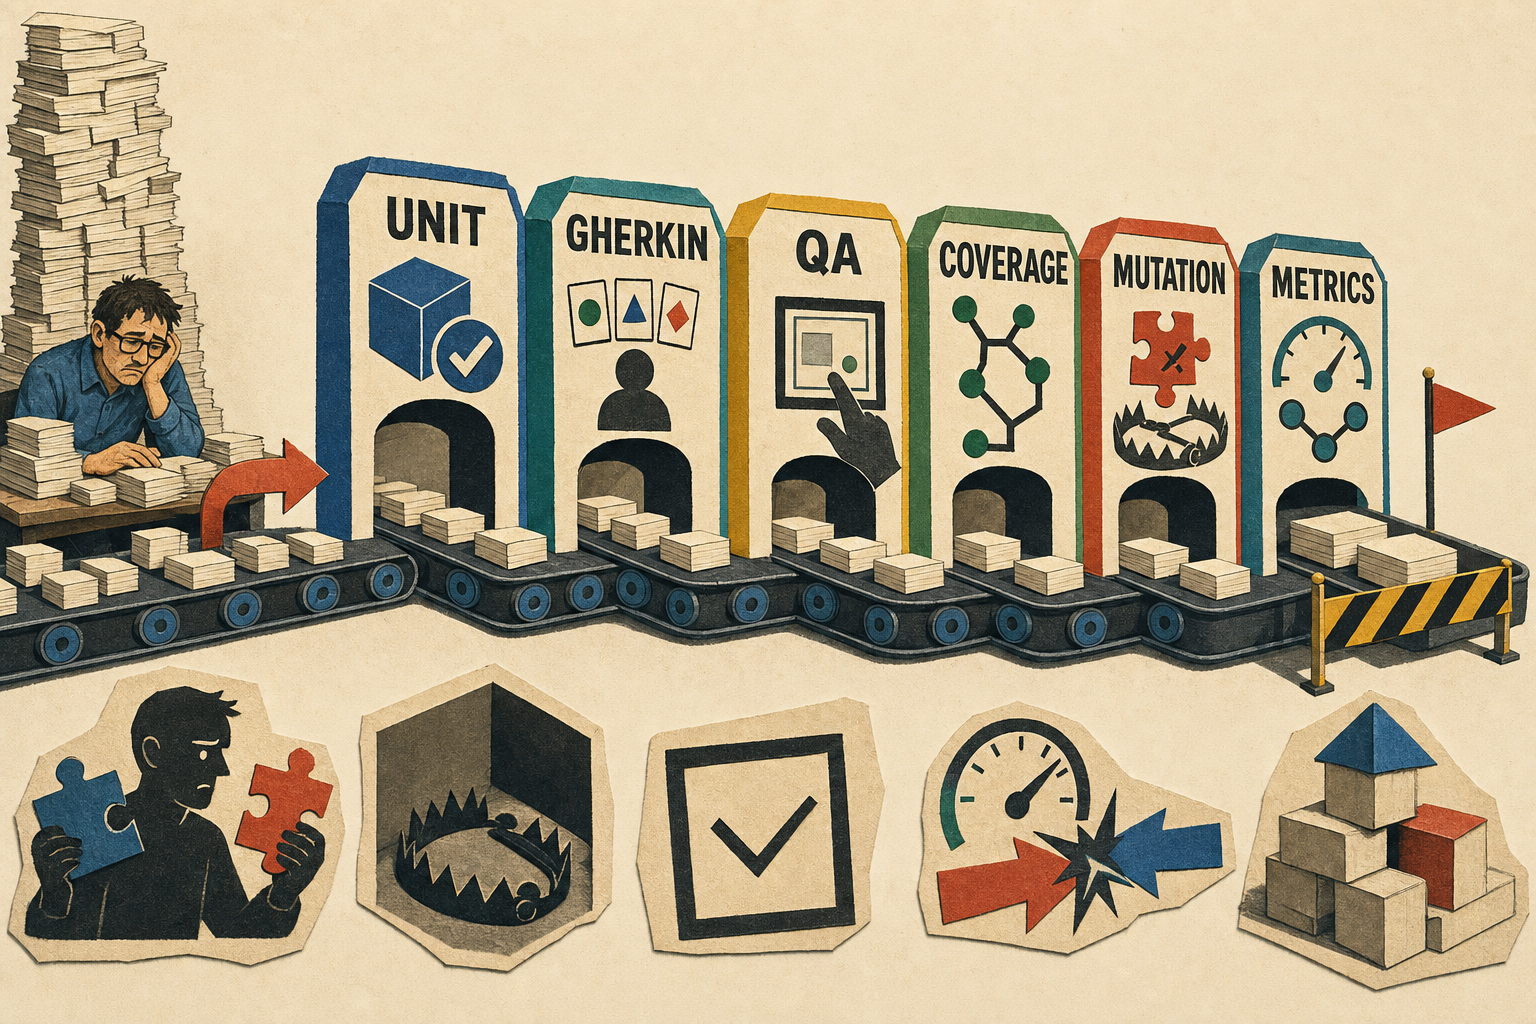
| 關卡工具 | 主要回答的問題 | 它無法單獨回答的問題 |
|---|---|---|
| Unit tests | 小單位的功能行為是否符合預期的已知案例? | 整體商業需求是否理解正確? |
| Gherkin tests | 使用者可觀察的高階行為是否符合規格敘述? | 規格是否漏掉了重要的邊界邊角情境? |
| QA / Manual test | 實際操作時的流程與體感是否符合期待? | 長尾異常情境與非功能性風險。 |
| Test Coverage | 哪些程式碼分支在測試執行時被跑過? | 測試裡的 Assertion 是否真的具有檢查力? |
| Mutation testing | 測試套件能否有效抓到程式碼被刻意注入的變更? | 效能退化、記憶體洩漏與併發(Concurrency)問題。 |
| Metrics 檢測 | 圈複雜度、模組大小與依賴結構是否超標? | 抽象化設計是否貼合業務領域(Domain)? |
這套方法的價值非常巨大:它把對 AI 的期待,從「希望 agent 寫 code 時自己小心一點」,轉變為「未通過機械化驗證前,一律不准合併」。
然而,當我們把所有信任都轉移到這套測試關卡時,全篇最棘手的一題就浮現了。
最難的一題:當 Agent 球員兼裁判
如果你的單元測試、Gherkin 規格甚至是 QA 手續,全部都是由同一隻 AI Agent 自動生成的,你會面臨軟體工程中最經典的 Oracle Problem(神諭問題):誰來驗證驗證者?
說穿了,這就是球員兼裁判。就像一個學生自己出考題、自己寫答案,最後再自己拿解答本改考卷。
這種球員兼裁判的架構,實際上會怎麼翻車?常見的劇本有三種。
最常見的:你給的需求本身就有模糊地帶,agent 寫實作時誤解了你的意思,寫測試時當然也帶著同一份誤解。實作錯了,測試也跟著錯,兩邊一對接,燈號全綠。這叫同源失敗(Correlated Failure),也是三種裡面最難靠事後檢查抓出來的。
第二種戲碼你在 KPI 職場劇裡一定看過:上有政策,下有對策。當「覆蓋率 90%」變成 agent 非過不可的硬門檻,LLM 會非常樂意生出一堆跑過每一行程式碼、assert 卻薄弱到幾乎沒有檢查力的廢測試。數字漂亮,保障趨近於零,正是古德哈特定律(Goodhart's Law)的經典展演。
最後一種比較隱微。模型評估自己的產出時往往過度樂觀,它寫 code 時看不到的邏輯盲區,改考卷時同樣看不到,這就是自評偏誤(Self-grading Bias)。
因此,驗證的獨立性其實是有梯度的。從最不可靠到最可靠,大體可以排成: Agent 自評 < 隔離 Context 的 Reviewer Agent < 確定性工具(Linters/Compiler) < 領域專家 / 真實 Production 反饋
當測試與實作出自同一手時,風險並沒有憑空消失,它只是從「程式碼寫錯」隱蔽地轉移到了「測試也跟著一起答錯」。
那麼,我們該如何打破這種非黑即白的困境?
看 Code 不必二選一:注意力是一座漏斗
很多討論喜歡把問題壓縮成「看 code 就是守舊,不看 code 就是前衛」。但這種假二分法在真實的工程世界裡完全站不住腳。
我更喜歡把審查注意力想像成一座漏斗:每一筆變更都會進來,但不是每一筆都值得沉到底。
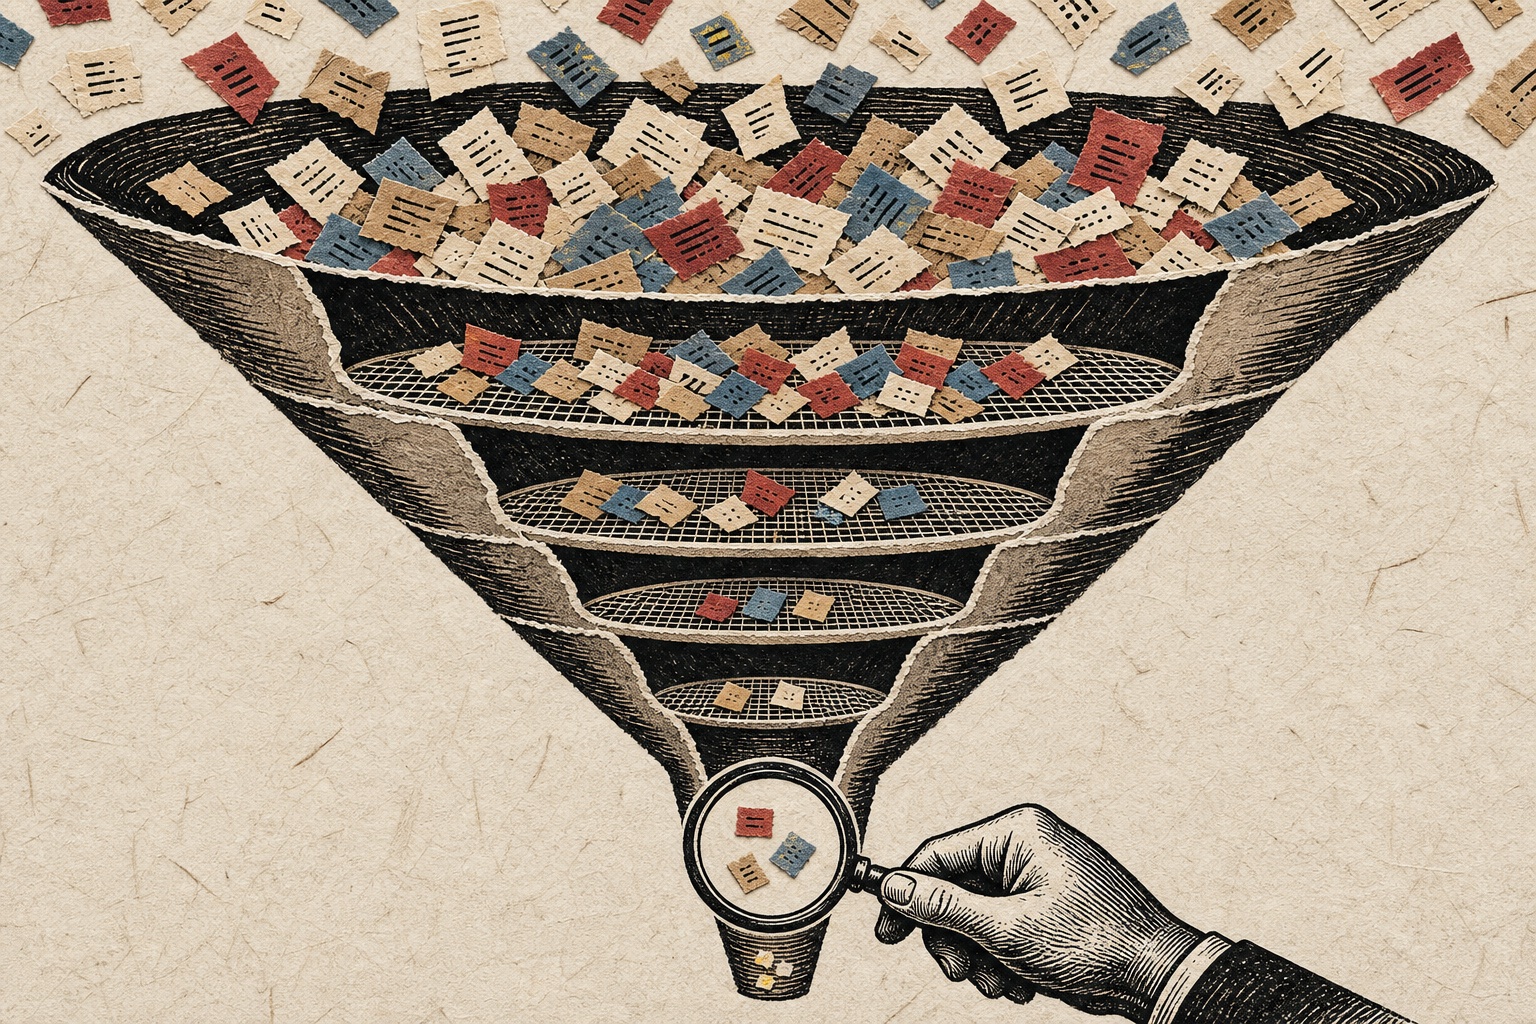
漏斗最寬的口,接住所有變更。在這一層,人只看功能 Demo、日誌可觀測性與 Rollback 機制,實作閱讀完全跳過,守門的粗活交給自動化關卡。往下窄一格,開始抽考卷:審 Gherkin 規格與測試案例的完整性,確認測試有沒有蓋對地方。再往下,翻開的是合約層:Public API、資料庫 Schema Migration 與模組邊界,具體的函式實作仍然不碰。
越深越窄,能沉到這裡的變更也越少:信任邊界(Trust Boundaries)、鑑權、金流、複雜演算法這些高風險路徑,值得人眼一條一條深讀。而漏斗最底部的窄口,才是傳統 code review 的預設姿勢,逐字逐行盯語法、細節與風格的 diff。人類注意力越往下單價越貴,所以能一路流到底的變更,本來就該是少數。
漏斗中段還橫著一道閥門:例外驅動。平常讓變更停在上層就好,等自動化關卡報錯、或多個 agent 的結論互相打架時,再把它拉進更深的層級人工介入。
團隊根本不需要宣誓自己屬於「看 code 派」還是「不看 code 派」。真正成熟的 vibe engineering,是根據每次變更的特性,決定它該沉到漏斗的哪一層。
什麼時候可以少看,什麼時候應該深入看
那麼,我們在日常開發中該如何決定今天的這張 PR 要沉到漏斗的哪一層?
我建議團隊可以從以下四個維度來進行風險評估:
- 損害範圍(Blast Radius):壞掉會影響誰?是本機開發工具,還是影響全公司的核心資料庫?
- 可觀測性(Observability):壞掉時容易被發現嗎?UI 走樣秒懂,但 Silent Data Corruption 或 Race Condition 極難察覺。
- 可逆性(Reversibility):壞掉時好救嗎?有 Feature Flag 可以秒關,還是需要執行不可逆的 DB Migration?
- 驗證獨立性(Verification Independence):測試與規格是 domain expert 寫的,還是模型自己照範本產生的?
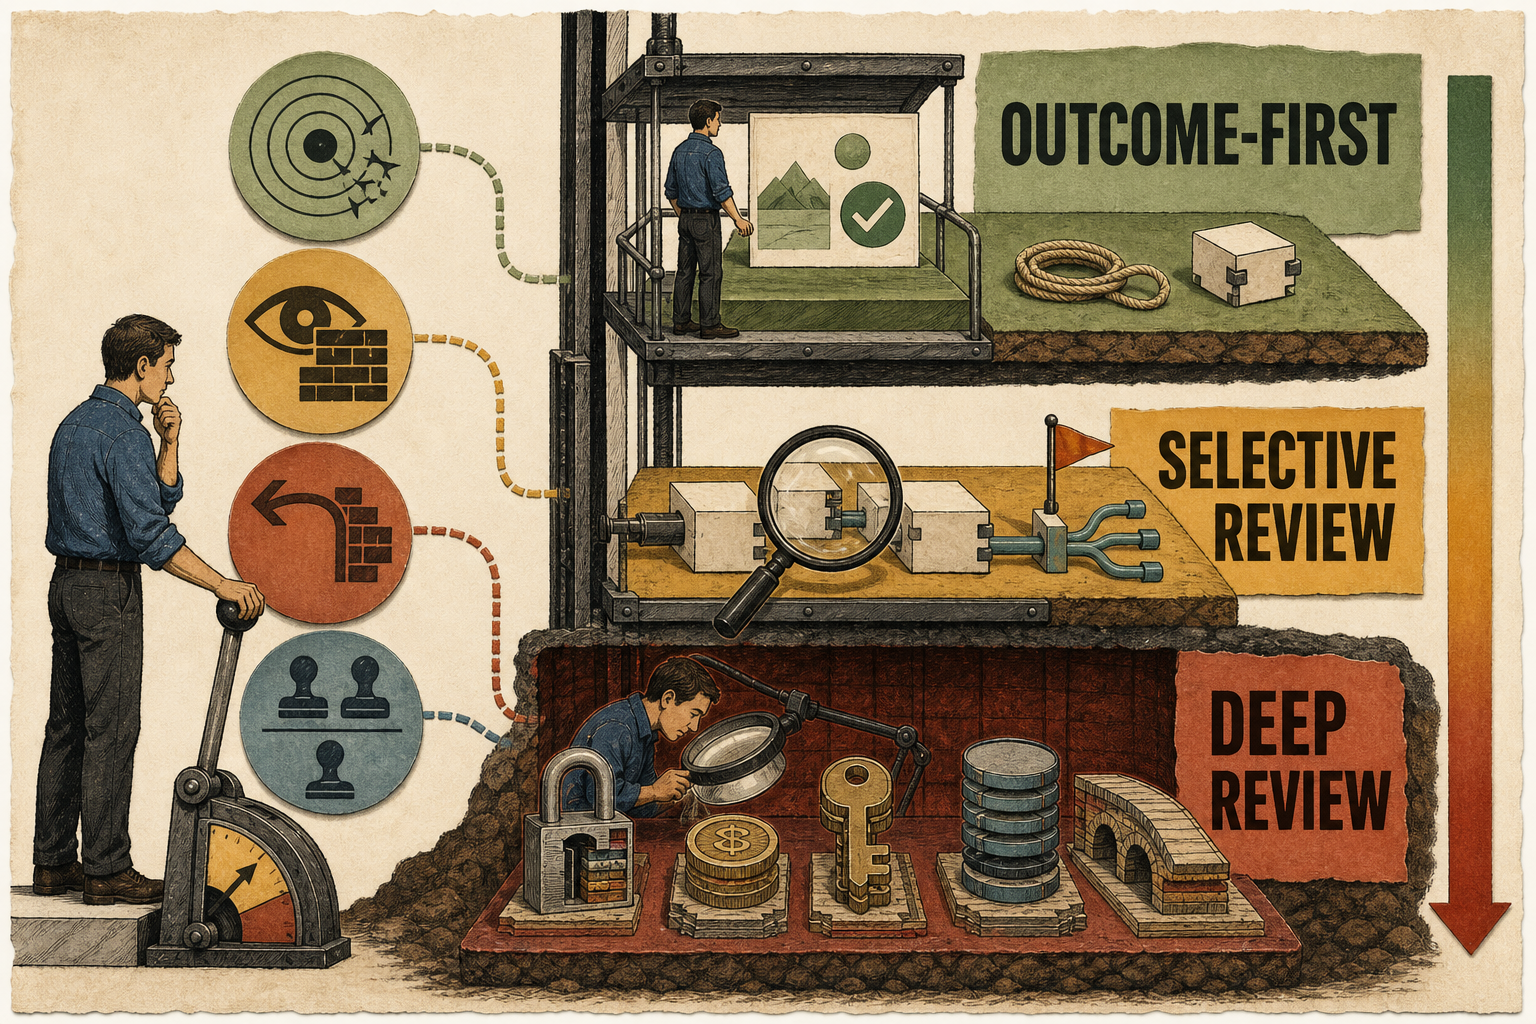
根據這四個軸,我們可以把開發情境整理成三級介入建議:
| 審查級別 | 適用情境案例 | 人類工程師主要看什麼 | 升級為深度審查的觸發條件 |
|---|---|---|---|
| 綠色:Outcome-first (可極度少看) | 用完即丟的腳本、拋棄式原型、低風險內部 Admin UI、CSS 樣式微調。 | 規格需求、操作 Demo、基本自動化測試燈號。 | 測試燈號異常、Agent 修正陷入無窮迴圈、變更範圍意外擴大。 |
| 黃色:Selective Review (重點抽查) | 一般產品新功能、既有模組重構、測試套件健全的業務邏輯。 | 介面合約(API Contract)、資料流向、高風險分支 Diff。 | 引入全新第三方依賴、涉及到 Data Schema 異動、效能指標退化。 |
| 紅色:Deep Review (必須深讀) | 身份驗證(Auth)、支付金流、權限控管、資料遷移、資安邊界。 | 逐行實作 Code、威脅模型(Threat Model)、架構設計。 | 原則上嚴格禁止降級,除非有長期生產環境證據支持。 |
這張表的核心精神在於:Code review 是一種風險控制工具,用它來當職業道德測驗就搞錯方向了。
當變更處於綠色區域,大膽放手交給自動化關卡才能取得生產力;但到了紅色區域,隨手 Accept All 就是在給未來的自己埋炸彈。
工程師的新工作:管理證據,也維持理解
當我們把大量打字與逐行審查的工作交出去後,工程師是不是就變得沒事做了?
恰恰相反。工程師的角色正在發生轉變,從過去的「程式碼產出者」,轉變為「邊界定義者與證據管理者」。
這種轉變帶出了一個關鍵的新能力:Context Engineering(上下文工程)。
Claude Code 團隊的 Thariq Shihipar 在 2026 年 7 月分享了一個非常有意思的觀察。他們在針對較新一代的模型進行測試時,刪除了 Claude Code 中超過 80% 的系統提示詞(System Prompt),結果 coding evaluations 的表現完全沒有退步。
Anthropic 在其技術文章中說明了原因:過多的提示詞、重複的規則與巨細靡遺的範例,反而會造成模型「過度約束」(overconstraint),讓 LLM 花費過多注意力在判斷該服從哪條規則上。更好的做法是提供乾淨的工具介面、漸進式揭露(progressive disclosure),並搭配明確的驗證迴路。
這項發現給了我們一個深刻的啟示:工程師的新工作,是設計出精簡且強大的驗證環境(Harness)。我們要把不可猜測的業務意圖寫成規範,把不可越過的邊界寫入執行環境,並讓測試與評估工具在正確的時間點介入。
同時,我們還必須警惕一種新的技術負債:認知負債(Cognitive Debt)。
如果一個團隊長期沒有任何人類去閱讀和理解系統的內部實作,雖然短期內功能一直在交付,但團隊對系統的掌控力會迅速衰退。一旦發生生產環境的突發災難,或是模型陷入無解的邏輯死結時,沒有人知道底下那些 code 究竟是怎麼跑起來的。
工程師升級成監工聽起來很瀟灑,但一個連藍圖都看不懂、只會看進度燈號的監工,並不會自動變成建築師的。
至於當實作大量交給 agent 之後,工程師手上還剩下什麼是貴的,我在後續的〈當 AI 已經會寫 Code,工程師的價值在哪?〉裡,從面試與自己的焦慮繼續往下想。
我把審查搬到動工之前:sdd-workflow
講了這麼多理論,我也得把自己的答案放上桌。
我最近開發的 sdd-workflow,出發點正是因為我發現 AI Agent 太容易在我還沒想清楚意圖之前,就急著衝出去改了一大堆程式碼。
sdd-workflow(Spec-Driven Development)的核心邏輯,就是把人類注意力從「事後看幾千行 diff」轉移到「事前審查與階段授權」。Agent 在動工前,必須先寫出一份包含問題定義、變更範圍與驗收條件的 Proposal;在人類閱讀並批准這份提案之前,它完全沒有權限修改任何實作程式碼。進入實作後,一次也只執行一個被批准的任務,每完成一步就更新狀態與證據。
流程對變化同樣設了防線:如果開發過程中發現需求改變,就強制回到提案修訂與重新批准,防止 Agent 偷偷把新需求混進舊的授權裡;一旦狀態或證據出現歧義,工具會選擇 fail closed,自動停止並交還給人類決定。
就像這篇文章本身的產出過程,其實就是一個自指(self-referential)的案例:
我先讓 Agent 建立了這篇文章的提案大綱,確定了論證脈絡、Uncle Bob 的立場核對與風險表格設計後,才授權它開始進行資料整理與文稿撰寫。
但我也必須誠實交代:sdd-workflow 解決的是控制流、權限與證據紀律的問題,它本身並不能作為程式碼完全正確的證明。 提案寫得再漂亮,裡面的商業邏輯依然可能出錯。它提供的是一副流程骨架,讓我們清楚知道何時該停下、該看哪種證據,以及由誰授權繼續。
它沒有解決所有程式碼正確性的問題,卻讓「不逐行讀完」不再等於「閉著眼睛相信」。
結論:把嚴謹放在最能產生信心的地方
回到最開始的問題:在 Vibe Engineering 時代,工程師還要看 code 嗎?
我的回答是:看或不看,不該是一勞永逸的信仰選擇,而是每一次變更都要重新回答的風險決策。
當你的需求規格明確、裁判工具獨立、執行結果容易觀測且隨時可以秒級 Rollback 時,大膽降低逐行閱讀的比例,把精力留給更具創造性的架構設計;但到了安全、金流、個資或任何失敗代價極高的高風險區域,依然要把 implementation 攤開來深度審視。
AI 確實讓程式碼的產出成本變得極度便宜,但工程信心並沒有隨之降價。
當我們決定少看一點程式碼時,最好先確認自己手上真的建立了一套可靠的 Gauntlet;並且清楚知道當哪一道關卡失靈時,自己會毫不猶豫地停下來,把那份程式碼仔細看清楚。