GEO/AEO 到底在做什麼?Google 官方說法與常見迷思
你在 ChatGPT、Perplexity 或 Google AI Mode 問問題時,答案旁邊常會掛幾個來源。生成式引擎最佳化(Generative Engine Optimization,GEO)與回答引擎最佳化(Answer Engine Optimization,AEO),就是業界用來描述「讓內容比較容易被這些系統找到、理解、引用」的叫法。
名字聽起來很新,但以 Google 來說,並沒有突然冒出一套神秘的 AI SEO 規則。頁面能不能被抓取、能不能正常索引,內容清不清楚、有沒有用,還是最穩的起點。
前陣子我做了一個開源檢測工具 geo-aeo-audit,想對網頁做 GEO/AEO 的靜態檢查;〈透過 Is Agentic 進行部落格健檢〉也提過相關概念。做的過程中我一直卡在同一件事:市面上的「AI SEO 必做清單」越列越長,有些項目看起來很專業,真要問證據,卻常常答不太出來。
所以這篇我想把三件事分開寫:官方明確說過的、研究觀察到的,以及我自己實作後的推論。這樣比較不會把「看起來該做」跟「真的有用」混在一起。
本文內容查證日期為 2026 年 9 月。平台規範與搜尋介面會變動,請以最新官方文件為準。
先講結論
| 問題 | 比較可靠的答案 |
|---|---|
| GEO/AEO 是什麼? | 描述 AI 搜尋能見度工作的業界用語,Google 仍把它放在 SEO 的延伸脈絡裡。 |
| 先做什麼? | 確認頁面可被抓取、可被索引,沒有誤設 noindex 或摘要限制,重要內容也確實出現在文字中。 |
| 內容怎麼寫? | 先回答問題,再補充背景、證據與限制;讓讀者和機器都能看懂段落在說什麼。 |
要不要做 llms.txt? | 若目標是 Google 搜尋曝光,目前優先順序很低,沒有可靠證據顯示它能提升 AI 引用率。 |
| Schema 有沒有用? | 對一般搜尋的複合式結果仍可能有用,但目前沒有「額外加一份 AI 專用 Schema 就會被引用」的通用規則。 |
如果你的網站本來就能正常索引,GEO 真的不必先開成一個大型專案。先把技術阻礙清掉,再把時間丟回高價值內容、第一手資料,以及實際有沒有帶來轉換。這樣通常比較划算,也比較不會被新名詞追著跑。
GEO/AEO 是 SEO 的另一個名字嗎?
嚴格來說,GEO 與 AEO 是業界用來描述工作方向的詞,不是 Google 或其他平台公布的排名開關。AEO 原本也可以涵蓋精選摘要、語音助理與問答介面;這篇我把範圍縮在生成式搜尋,不然題目會散掉。
Google 的官方文件直接把 AEO、GEO 列為「用來描述提升 AI 搜尋能見度的用語」,同時表示,從 Google Search 的角度看,這些工作仍然屬於 SEO。AI Overviews 與 AI Mode 沒有額外的特殊技術要求,頁面仍須符合一般搜尋的索引與摘要條件。
這點我覺得很重要:你不必為了追一個新名詞,把原本有效的內容與技術工作全部推倒重來。
AI 搜尋怎麼遇到你的內容?
我自己比較好記的方式,是把它想成一條路:系統先找到網址,再讀取頁面、判斷內容和問題是否相關,最後才決定要不要放進回答或來源列表。不同平台的內部流程不完全一樣;就算頁面條件都對了,也不保證一定會被引用。
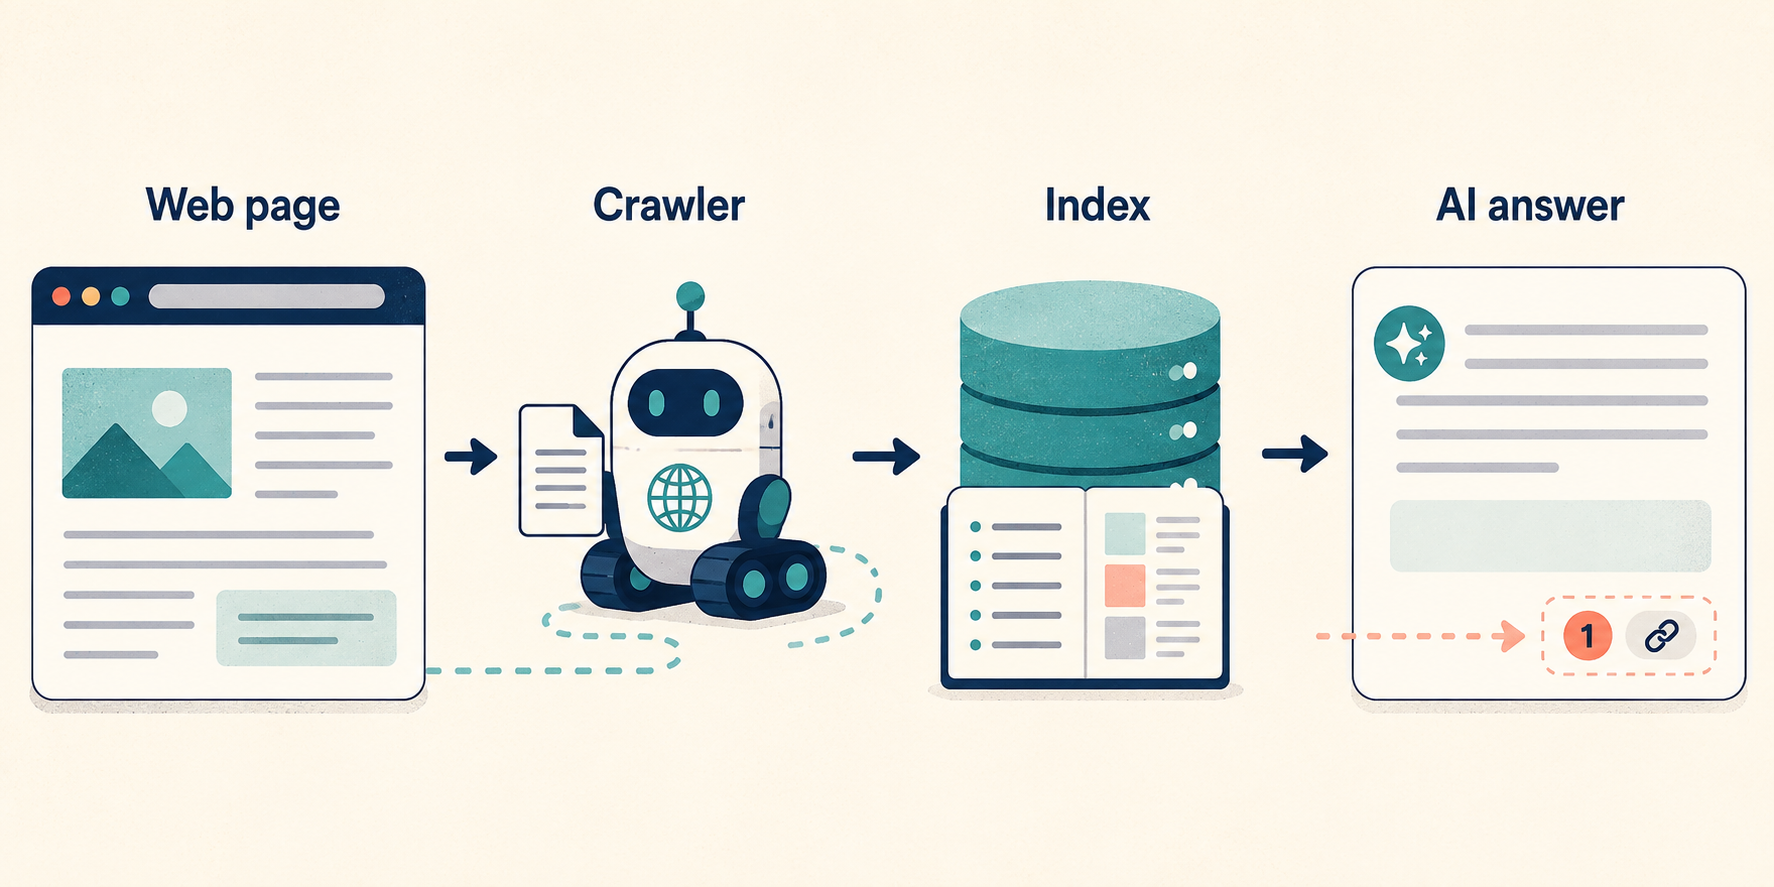
這是一條可能的內容流轉路徑;能被抓取、索引,仍不代表一定會出現在 AI 回答中。
做網站時最常碰到的 crawler,大致可以分成三類:
- 搜尋索引 crawler。 例如
Googlebot、OAI-SearchBot與PerplexityBot,主要任務是建立或更新搜尋系統可用的資料。若希望出現在特定平台的搜尋結果,通常要允許該平台的搜尋 crawler 存取,例如 OpenAI 對OAI-SearchBot的說明。 - 模型訓練 crawler。 例如
GPTBot與ClaudeBot,用途和搜尋索引不同。網站可以依照版權、商業策略與平台政策決定是否允許。 - 使用者觸發的 fetcher。 例如
ChatGPT-User或Perplexity-User,當使用者要求系統讀取某個網址時才發出請求。這類請求的 robots 規則可能和自動搜尋 crawler 不同,不能混在一起理解。
robots.txt 比較像「爬蟲能不能進門」的告示牌。它不是排名保證,也不等於資料一定會被使用;不同平台是否遵守、如何解讀,都要看各自的官方文件。實務上我遇過最常見的狀況,是把這三類 crawler 當成同一件事在擋,結果搜尋曝光跟訓練授權一起被搞亂。
真正值得做的內容整理
先回答問題,再補充脈絡
標題在問「GEO 是什麼」,開頭就先給定義。個人經驗、背景故事與延伸討論可以留,我自己也常這樣寫;但別讓讀者讀了半天,還在猜這篇到底要回答什麼。
例如讀者問:「GEO 要先做什麼?」下面這種寫法先繞背景,看完仍不知道該做什麼:
AI 搜尋正在改變大家找資料的方式,網站經營者也開始研究 GEO。這幾年出現了很多新的最佳化方法,值得我們持續觀察。可以改成先回答,再補原因:
GEO 要先做的是確認頁面能被抓取、索引,並把答案寫清楚。這些條件是內容被搜尋系統找到和理解的基本起點,之後再依需求處理結構化資料或其他格式。讀者會先拿到可執行的答案,再決定要不要繼續讀背景。這對人也比較友善,對機器通常也好懂一點。
讓重要主張可以被驗證
數字、版本、政策與產品行為都該附上來源。找不到可靠來源時,就老實說這是觀察,或標「目前還沒有足夠證據」。我寧願把限制講清楚,也不想塞一個看起來很準、卻說不清根據的數字。
例如下面這句把推測寫成保證,讀者無法知道根據是什麼:
只要加上 Schema,網站就會更容易被 AI 引用。比較可靠的寫法會交代來源和證據範圍:
Google 官方文件表示,AI Overviews 與 AI Mode 沒有額外的 AI 專用 Schema 要求。Schema 對一般搜尋的複合式結果仍可能有用途,但目前沒有足夠證據證明它必然提高 AI 引用率。這樣讀者分得清哪些是官方說法、哪些仍是觀察或推論,也知道結論還有哪些限制。寫文章時我會一直問自己:這句如果被追問「你怎麼知道」,我答不答得出來?
使用清楚的段落與標題
好的標題和小標題能幫讀者定位,也可能讓搜尋系統更容易判斷段落和問題的關係。這不代表每個小標題都要硬塞關鍵字。讀者看得懂,通常就夠了。
例如讀者想知道:「GEO 需要另外一套技術嗎?」下面這種寫法只有背景,答案還得自己找:
最近很多人都在討論 AI SEO,大家也開始研究各種新的檔案格式和標記方式。網站經營者可能會想知道,現在到底該從哪裡開始準備。可以改成先用小標題提出問題,再在第一句直接回答:
### GEO 需要另外一套技術嗎?

目前不需要。以 Google 為例,AI Overviews 與 AI Mode 沿用一般搜尋的基本條件:頁面要能被抓取、索引,內容也要清楚、有用。先確認這些基本條件,再考慮其他內容整理方式,通常比較可靠。小標題對上問題、第一句先給結論、後面再補範圍與理由。人讀起來省力,搜尋系統也比較容易判斷這一段在講什麼。
技術面先檢查三件事
1. 確認 crawler 沒有被意外擋住
下面只是示意設定,不是每個網站都該直接複製的標準答案:
User-agent: Googlebot
Allow: /

User-agent: OAI-SearchBot
Allow: /

User-agent: GPTBot
Disallow: /

Sitemap: https://example.com/sitemap.xml沒有 Disallow 規則時,crawler 原則上已可存取,不必為每個平台逐一加 Allow: /。實際設定仍要連同既有的 User-agent: * 規則一起判讀。
Googlebot 和 OAI-SearchBot 代表不同平台的搜尋存取權;GPTBot 則是模型訓練用途。允不允許,按網站自己的內容策略決定就好。沒有標準答案,只有你願不願意被拿去訓練、希不希望出現在某家搜尋裡。
另外,Google-Extended 不是獨立的 HTTP crawler。它是 robots.txt 裡的控制標記,用來管理部分 Gemini 系統的訓練與 grounding,不影響網站是否出現在 Google Search,也不能拿來阻止 Google AI Overviews。Google 的 crawler 文件有列出這個差異。這個名字很容易讓人以為又多了一隻爬蟲,第一次看到時我也愣了一下。
2. 分清楚 robots.txt、noindex 與 nosnippet
這三個設定處理的是不同問題:
robots.txt:告訴 crawler 哪些路徑可以抓取。noindex:頁面可以被讀取,但不要放進搜尋索引。nosnippet、max-snippet:限制搜尋結果可顯示或使用的文字片段。對 Google 來說,也會影響 AI Overviews 與 AI Mode 能否把頁面文字當成直接輸入,細節可參考 robots meta 標籤文件。
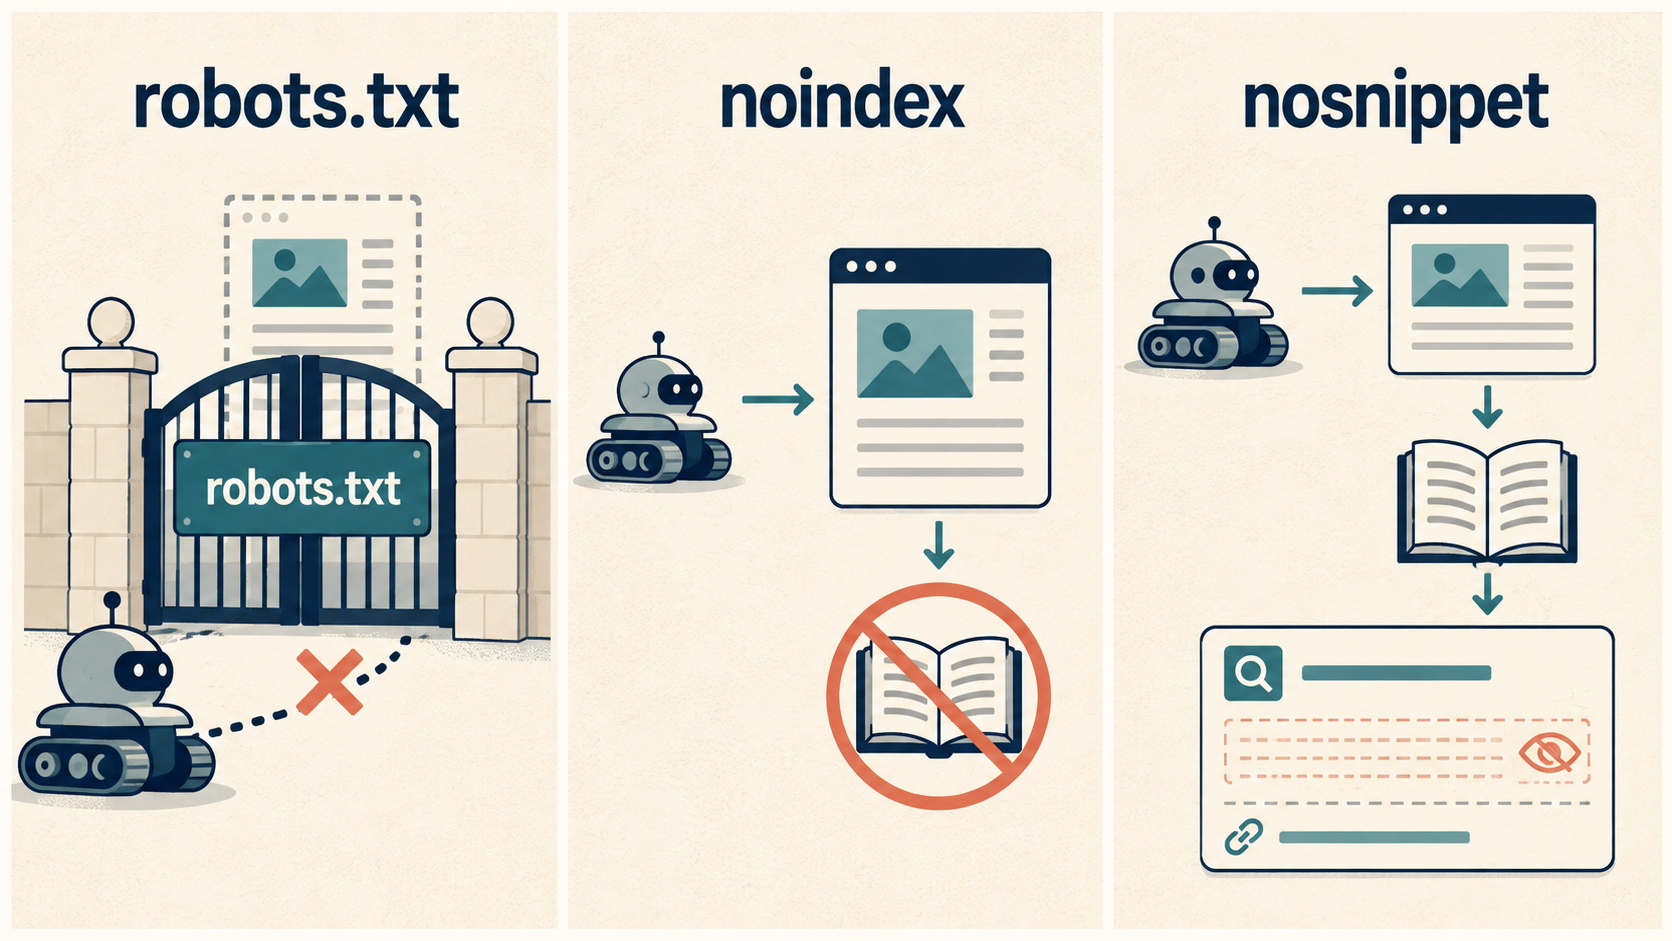
三者分別控制抓取、索引與摘要/文字片段的使用範圍。
目標是增加被搜尋或被引用的機會時,先檢查有沒有誤用 noindex、nosnippet 或 max-snippet:0。本來就有意限制曝光的話,這些設定當然不必移除;重點是別在想被找到的同時,又默默把自己關起來。
3. 確認頁面真的能被讀懂
可以用 curl -I https://example.com/page 檢查 HTTP 標頭,再查看 HTML 原始碼中的 <meta name="robots">。兩邊都要看,因為 curl -I 看不到 HTML 裡的 meta 標籤。只看其中一邊,很容易誤判。
Google Search Console 的網址審查工具可以協助確認 Googlebot 取得的內容。Server Access Logs 則能告訴你 crawler 有沒有來、回應是否成功。回傳 200 只代表請求成功,不代表頁面一定會被索引或引用。這點很無聊,但排查時超常見。
幾個常見迷思
迷思一:加結構化資料就能換取 AI 引用?
結構化資料對一般搜尋的複合式結果仍有用途,Google 也建議網站提供完整、正確,並且和頁面可見內容一致的資料。但 Google 官方文件同時表示,沒有必要為 AI Overviews 或 AI Mode 另外建立特殊的 Schema。
Ahrefs 的研究追蹤 1,885 個新增 JSON-LD 的頁面,並以 4,000 個頁面作為對照。研究在 Google AI Overviews、AI Mode 與 ChatGPT 上都沒有觀察到明顯引用提升;AI Overviews 的相對差異是下降 4.6%,但研究作者也提醒,這份資料無法單獨證明 Schema 導致下降。
我自己的讀法比較保守:該做 Schema 時,為了一般搜尋結果做對就好;別把它當成 AI 引用的保證按鈕。
迷思二:文章越長越容易被引用?
Ahrefs 的分析涵蓋 174,048 個出現在 AI Overviews 的頁面,字數和引用位置的 Spearman 相關係數是 0.04,53.4% 的頁面少於 1,000 字。這項研究不能證明短文一定更好,只能說「為了湊字數」沒有明顯理由。
寫到足以回答問題就好。該補的例子、限制與證據要補;讀者不需要的填充,刪了通常更痛快。
迷思三:只要更新發布日期,AI 就會重新引用?
發布日期和更新日期要反映真實狀況,不能只改數字製造新鮮感。公開研究對不同平台的結果並不一致,Google AI Overviews、ChatGPT、Perplexity 也可能使用不同的檢索與排序方式。
另一份分析 120 萬個 ChatGPT 回答的研究指出,44.2% 的引用出現在文章前 30% 的內容。這比較支持「把重要定義和答案放前面」,不代表只要把日期改新就能增加引用。Search Engine Land 對該研究的整理
迷思四:一定要建立 llms.txt?
Google 官方指南明確表示,Google Search 不使用 llms.txt;建立它不會提升或降低網站在 Google Search 的能見度。現有可靠證據也不足以支持它能提升 AI 引用率。John Mueller 也曾在 2025 年 6 月 17 日的公開貼文表示,當時沒有 AI 系統使用 llms.txt。
如果團隊的自建代理流程已明確讀取這份檔案,它可以作為大量文件或 API 的人工維護索引;單純把檔案放上網站,則不代表外部 AI 系統會自動採用。若目標只是搜尋曝光,應先處理 robots、索引、內容品質與量測。llms.txt 可以之後再回來談,不用排在第一天。
成效要怎麼看?
「被 AI 引用」可以當成觀察指標,但不適合單獨當成成功定義。Google 已在 Search Console 提供 Generative AI performance report,可查看網站在 AI Overviews 與 AI Mode 中的曝光,並依頁面、國家與裝置分析;這些資料仍屬於 Web search type。實務上我還是會看 Analytics、站內搜尋、註冊、詢問與購買:曝光有沒有換成真正有用的行為。
不同平台的回答也可能因為地區、登入狀態、提問方式與時間而不同。偶爾在某個模型問到自己的網站,開心一下可以,別直接當成穩定排名。固定問一組問題、持續觀察,比較有機會看出方向。
結語
對我來說,GEO/AEO 比較像重新檢查 SEO 基本功的契機。先讓搜尋系統找得到頁面,再把答案、證據與限制寫清楚,最後用流量和轉換驗證內容是否真的有幫助。至於 llms.txt、特殊 Schema 或固定字數,等有明確需求與可靠證據再投入時間就好。新名詞會一直來,基本功比較耐用。
附錄:常見 crawler 例子
| 平台 | Token | 主要用途 |
|---|---|---|
Googlebot | Google Search 的自動抓取 | |
Google-Extended | 部分 Gemini 系統的訓練與 grounding 控制標記,沒有獨立 User-Agent | |
| OpenAI | OAI-SearchBot | ChatGPT 搜尋 |
| OpenAI | GPTBot | 模型訓練 |
| OpenAI | ChatGPT-User | 使用者要求 ChatGPT 讀取網址時的請求 |
| Perplexity | PerplexityBot | Perplexity 搜尋 |
這張表只列代表性例子,不是完整的跨平台規格。平台的 User-Agent、用途與 robots.txt 行為會變動,實作前應直接查看各家的官方文件。
參考資料
官方文件與原始研究:
- Google,AI features and your website
- Google,Optimizing your website for generative AI features on Google Search
- Google,Robots meta tags specifications
- Google,Google's common crawlers and Google-Extended
- OpenAI,Overview of OpenAI Crawlers
- Perplexity,Perplexity Crawlers
- Aggarwal 等,GEO: Generative Engine Optimization,KDD 2024
- Puerto 等,C-SEO Bench: Does Conversational SEO Work?,NeurIPS 2025 Datasets and Benchmarks
公開分析資料:
- Ahrefs,We Tracked 1,885 Pages Adding Schema
- Ahrefs,Short vs. Long Content in AI Overviews
- Ahrefs,Why ChatGPT Cites One Page Over Another
- Search Engine Land,44% of ChatGPT citations come from the first third of content
- John Mueller,llms.txt 的公開說明