JSDC 2025 演講回顧:讓 AI 寫前端,我們來寫未來
終於結束了! 上週六很榮幸能在 JSDC 2025 跟大家分享「讓 AI 寫前端,我們來寫未來」這個主題。 老實說,雖然我從第一屆 JSDC 上台到現在已經十多年了,但還是第一次講這麼不 JavaScript 的主題(笑)
除了蹭一下 AI 熱潮,這場演講想探討的,就是在 AI 工具越來越強大的今天, 我們前端工程師該如何與 AI 協作,避免掉入「Vibe Coding」的陷阱,同時又能善用 AI 的生產力,提升開發效率與品質。
關於 JSDC 2025
JSDC(JavaScript Developer Conference)是台灣最大的 JavaScript 年度技術研討會,自 2011 年起由多個開發者社群共同發起,致力於提供台灣中高階 JavaScript 技術人才與世界最新技術交流的平台,整合獨立開發者、企業與組織的技術力量。
今年的 JSDC 2025 於 11 月 29 日在集思台大會議中心舉辦,主題是「Code Compose Connect」,聚焦在生成式工具與智慧化開發流程的發展,探討開發者如何透過協作重新定義創作的邊界。
今年 JSDC 最大的感觸就是:AI 真的無所不在。 不只是我的場次,我聽其他講者分享時,大家都不約而同地聊到 AI 如何改變開發流程,工具鏈,甚至是產品設計思維。 這種氛圍讓我深刻感受到,AI 已經不再是「未來的趨勢」,而是「現在進行式」的現實。
演講內容回顧
在演講一開始,我做了一個簡單的田野調查:「現場有多少人已經在用 AI 輔助開發?」
結果目測有九成以上的人舉手。
這個數字其實不意外,但親眼看到還是蠻震撼的。 AI 輔助開發現在已經不是「要不要用」的問題,而是「怎麼用才不會踩坑」的問題。
什麼是 Vibe Coding?
接著我用一個場景帶入:「三分鐘用 AI 生成一個電商產品頁」。 畫面看起來很漂亮,但打開 Console 一看,滿滿的紅字錯誤。
這就是所謂的 Vibe Coding:憑感覺寫 Code。 戴上耳機,感覺對了,Code 生成了,畫面出來了,看起來很美。 但身為工程師的我們都知道,看起來能動跟真的能上線,中間隔著一道巨大的鴻溝。表面上省了時間,底層卻埋了更多技術債,填坑填不完。
六個開發階段的 AI 協作陷阱
我把前端開發拆成六個階段,分析每個階段 Vibe Coding 容易踩的坑,以及如何避免:
| 階段 | Vibe Coding 的坑 | 解法 |
|---|---|---|
| Phase 1: 需求分析 | AI 只處理 Happy Path,Edge Cases 得靠人想 | Interface First:先定義資料結構和元件介面 |
| Phase 2: 視覺切版 | AI 亂猜顏色、間距、圓角,造成「視覺負債」 | Design Tokens:綁進 Tailwind,限制 AI 只能用定義的值 |
| Phase 3: 元件實作 | AI 幻覺(漏 .value、混用 API、過時語法) | Rules 檔案:.cursorrules 或 CLAUDE.md |
| Phase 4: 前後端整合 | 只寫 Happy Path,不處理 Loading/Error/Race Condition | OpenAPI + MCP:提供即時規格和 Checklist |
| Phase 5: 測試與品質 | 測試只測 Happy Path,Mock 太多沒意義 | TDD 思維:人寫測試定義正確,AI 寫實作 |
| Phase 6: 效能與部署 | 「能跑」不等於「能上線」 | Pre-deployment Checklist:Lighthouse、Bundle Size、敏感資訊檢查 |
Prompt Engineering 已死?Context Engineering 當立!
演講後半段,我提出一個觀點:重點不是「怎麼問」(Prompt Engineering),而是「給什麼」(Context Engineering)。
什麼是 Context Engineering?
根據 Anthropic 的定義,Context 指的是「在對 LLM 取樣時所包含的所有 token」,而 Context Engineering 就是「針對 LLM 固有的限制,優化這些 token 的效用」。LangChain 的文章 則給了更實務的定義:
Context Engineering 是建構動態系統,以正確的格式提供正確的資訊和工具,讓 LLM 能夠合理地完成任務。
簡單來說,Prompt Engineering 關注「怎麼問」,用詞彙和技巧調整 AI 行為;Context Engineering 關注「給什麼」,用結構化的資訊架構引導 AI。
為什麼 Context Engineering 更重要?
大多數 AI Agent 失敗的原因,不是模型能力不足,而是沒有提供適當的背景資訊給模型。
LLM 有一個特性叫 Context Rot:隨著 Context Window 中的 token 數量增加,模型回憶資訊的準確度會下降。Context 是有限資源,不是塞越多越好,而是要精準地提供「對的資訊」。AI 的智商取決於模型,但 AI 的準確度取決於 Context。
前端開發的四種 Context
在演講中,我把 Context Engineering 對應到前端開發的四個階段,整理成四種 Context 類型:
Data Context(資料的形狀)
對應需求分析階段。就是 TypeScript 的 Types 和 Interfaces。
還記得前面講的嗎?先定義 Product interface,裡面有 status 欄位,AI 就知道要處理缺貨狀態。資料的形狀決定了 AI 要處理什麼,這就是「給方向,不給答案」,你定義結構,AI 填內容。
Visual Context(視覺的邊界)
對應視覺切版階段。就是 Design Tokens。
把顏色、間距、圓角都定義好綁進 Tailwind,AI 就只能在這個範圍內選擇。這是「限制選擇範圍」的概念,與其寫一堆「不要用 #ff0000」,不如直接定義「只能用這幾個顏色」。限制選擇,就是提高準確度。
Constraint Context(規則與禁令)
對應元件實作階段。就是 .cursorrules 或 CLAUDE.md。
告訴 AI:NEVER use any、ALWAYS use Composition API、記得加 .value。明確的禁止和要求,讓 AI 知道邊界在哪。這裡「給範例比給規則有效」,與其寫一堆規則,不如在 Rules 檔案裡放幾個標準的元件範例讓 AI 參考。
Knowledge Context(即時的規格與知識)
對應前後端整合階段。這裡有兩個面向:
一個是 API 規格。如果有 OpenAPI (Swagger) spec,AI 可以根據正確的 API 合約生成 Client Code,不用你一個一個欄位跟它講。這是跟後端協作的基礎。
另一個是即時知識。AI 的訓練資料可能停在一年前,它不知道 Vue 3.5 可以解構 props。透過 MCP,AI 可以即時查詢最新文件、資料庫 Schema,用對的方式寫 Code。
還沒導入 MCP 也沒關係,先把 openapi.yaml 或 schema.sql 放在專案的 docs/ 資料夾,在規則檔裡指引 AI 去讀,也是一個好的開始。
為什麼叫「工程」而不是「技巧」?因為這是系統性的方法。你不是在賭 AI 這次會不會寫對,而是在建構一個環境,讓 AI 在這個環境裡面只能寫對。
這四個 Context 剛好對應到前面講的四個開發階段,這不是巧合。 AI 時代的前端架構,其實就是在為 AI 建構一個高品質的 Context 環境。
會眾 Q&A 補充
由於時間關係,在現場沒能進行 Q&A,所以我在這裡整理幾個會眾透過 Slido 提出的問題。
Q1: Design Token 感覺是設計師的工作,前端該怎麼辦?
在讓 AI 寫前端畫面時,定義 design token 或畫面相關要給的規格感覺是設計師的工作,我們身為前端工程師該怎麼自己通靈規格,或改怎麼跟設計師要求規格?或是我們身為前端工程師,有推薦該如何學習哪些設計概念以加強 AI 的產出嗎?
很多前端會覺得「這是設計師的事吧?」,但現實是,很多時候我們根本沒有設計師,或者設計師沒空理你。這時候前端自己把 Token 定義起來,其實是在救自己。
如果你有設計師,可以主動拿著 Design Token 的概念去跟他聊,說明這樣做可以讓開發更一致、修改更方便。很多設計師其實樂見這種系統化的做法,只是不知道怎麼開始。Figma 本身就有 Variables 功能可以定義 Design Token。
如果設計稿已經給了,那就自己整理出重複使用的顏色、間距、圓角。你甚至可以用 AI 幫你分析:「請從這份設計稿中整理出常用的顏色、間距、字體大小」。
另外推薦了解一些基本設計概念:8px Grid System(間距用 8 的倍數)、Typography Scale(字體大小有規律的比例)、Color System(主色、輔色、語意色)。不需要變成設計師,但這些知識能讓你跟設計師溝通更順暢。
實在不想自己搞的話,Tailwind 本身的預設值就是經過設計的系統,直接用 text-lg、p-4、rounded-md 這些 class,已經比亂猜數值好很多了。
Q2: AI 可以幫忙統合不同團隊的程式碼嗎?
假設一個官網有英文版和中文版,是個別由不同團隊開發的網站,所以開發方法、初始定義的樣式、元件模組都是個別刻的。但後來希望能盡量統合成一致、同步規格,以便加快復刻的範例。定義成一致的規格當作 design token 給 AI 去復刻?
可以,但別想一步到位。
我會建議這樣做:先讓 AI 分別讀兩邊的程式碼,整理出各自的命名慣例、元件結構、樣式寫法。這一步是為了搞清楚「差異在哪」。
接下來,「要統一成哪一種」這件事得由人來決定。哪邊的寫法比較好維護?哪邊的團隊比較大需要遷就?有沒有第三種更好的方式?這些 AI 沒辦法幫你判斷。
決定好之後,把統一的 Design Token、元件 Props 介面、Coding Style 寫成規格文件,這份文件就會成為 AI 的 Context。
最後是漸進式重構。不要想一次全改,從新功能開始用統一規格,舊的部分有碰到再逐步調整就好。
不過說真的,這種跨團隊的統合,溝通成本往往比技術成本高。AI 可以幫你產出程式碼,但「讓兩個團隊同意用同一套規格」這件事,還是得靠人去喬。
Q3: 實務上很難全部做到,技術債持續增加怎麼辦?
概念上能理解講者講的各個原則、執行要注意的細項,但是實務上覺得還是很難全部做到,尤其目前專案已經越來越多技術債增加的感覺。想聽講者對實務上克服的看法。
講是講「理想狀態」,但我自己也沒辦法 100% 做到(笑)。重點不是追求完美,而是「不要讓新的債繼續堆上去」。
如果現在專案一團亂,不可能一夜之間變好。 我的做法是「每次碰到的程式碼,離開時比來時乾淨一點」就好。 舊的技術債先放著,但新功能開始導入 Interface First、Design Token 這些做法,至少新的部分不會繼續堆債。
要挑的話,先挑 ROI 高的做。 像是建立 Rules 檔案(.cursorrules 或 CLAUDE.md),當我們規則寫得好,寫一次就能讓 AI 每次都遵守,投資報酬率超高。 Design Token 也是,建立一次之後效益是累積的。
另外,技術債很多時候來自「團隊沒有共識」。與其靠 Code Review 抓問題,不如把規則寫進 ESLint、寫進 AI Rules,用工具自動化的約束比口頭約定可靠多了。
還有,AI 很擅長做「把所有 var 改成 const」、「把 Options API 改成 Composition API」 之類的重構, 搭配 MCP 讓 AI 去讀官方文件,AI 可以幫你把舊程式碼升級到新標準,最後我們只要驗收就好。
這樣就可以把人力放在更高價值的地方,讓 AI 當苦力,人專注在架構決策就好。
Q4: 有些規則是 AI 產出後才發現需要的,怎麼辦?
規格要在 AI 產出前先寫清楚,避免規則後補,但有些細節有可能 AI 產出後才發現我希望遵循某些規則或細節,算是一種不理解自己需求或是無法清楚表達所有細節的狀況?請問這狀況要如何改善?
這完全正常,不需要太焦慮。規則本來就是「迭代」出來的,不可能一開始就想到所有細節。
我的做法是:AI 產出一段程式碼,發現「欸,這邊應該要怎樣怎樣」,就立刻把這個規則加進 Rules 檔案,然後再讓 AI 讀取新的 Rules,重新產出。 這樣不斷累積規則,AI 寫出來的東西就會越來越符合團隊需求。
我們可以建立一份「AI 踩過的坑」清單,每次 AI 做錯什麼就記下來變成規則。這份清單會越來越完整,最後就是你團隊專屬的 Best Practice。
其實這是一個學習過程:你對 AI 的理解在加深,AI 對你專案的理解也在累積(透過 Rules 檔案)。前幾次會比較痛苦,後面會越來越順。
不要覺得這是「不理解自己需求」。很多細節本來就是做了才會浮現,傳統開發也一樣, 寫著寫著才發現「啊,這邊需要處理 xxx 狀況」,差別只是以前自己寫自己改,現在是跟 AI 協作而已。
Q5: 只會寫 code 的工程師是否岌岌可危?
看起來用 AI coding 最重要的是讓它能理解需求、想要的工具以及目的。但這樣來說,coding 對我們工程師來說已經不是最重要的,而是「釐清」。也想請教說,是不是「只會寫 code」的工程師未來是不是岌岌可危,或是我們該要有怎麼樣的 mindset?
這題我想拆開來聊。
「會寫 code」變成基本功,而不是全部價值
把「會寫 code」比喻成「會用 Word」,聽起來有點誇張,但想講的是:以前「把需求轉成程式碼」這個轉譯過程本身就很稀有、有價值。現在有 AI,「把自然語言變成程式碼」這一段越來越可以被工具代勞,但「寫什麼、為什麼要這樣寫、整體系統要長什麼樣子」還是人決定。
所以 code 變成「你跟 AI 溝通的語言」和「你驗收成果的工具」,而不是你唯一的產出。但這不代表你可以不會寫 code,不會寫 code,基本上很難「管得住」AI 寫出來的東西。
真正的價值在「AI 不擅長」的地方
釐清問題 / 需求分析:AI 可以幫忙整理、brainstorm,但真正的需求來自商業目標、限制、風險、時間、預算,這些是「政治 + 商業 + 人性」的綜合產物。AI 可以記住、推理已知的規則,但它不會主動 challenge「這個需求有意義嗎?」、不會問「這個 KPI 設對了嗎?」、沒有「政治後果意識」與「長期責任感」。能清楚說出「我們到底在解什麼問題?不做這功能會怎樣?」這個能力超值錢。
系統 / 架構設計:AI 很會「給你某個檔案的程式碼」,但「整個系統要拆幾個 service?資料流怎麼走?未來容易改嗎?安全性?擴充性?」這些高維度的 trade-off,牽涉到團隊能力、既有系統、部署環境、組織文化。這種「設計空間的決策」,AI 可以給選項,但最後要你扛責任。
品質把關:包含 code review、測試策略、觀察指標、風險評估。AI 可以幫你寫測試、生成 code,但「測試有沒有測到重點?這個改動會不會踩到別的系統?這個實作在高流量、高錯誤率情境下撐得住嗎?」這些是經驗 + 系統性思維,不是單純語言模型就能搞定的。
溝通協調:AI 可以幫很多「低層工作」,像是整理會議重點、把技術說明翻成 PM 聽得懂的話、列 pro/cons 當溝通素材。但真正難的是:判斷「現在這個場要講真話還是講安慰版」、在衝突中拿捏立場、願意站出來說「現在的做法會爆,大家要不要一起調整?」這種「關係 + 風險 + 誠實度」的東西,靠的是人。
一個重要前提:你本來就要有不錯的工程基礎
「大家都來當管 AI 的人」這句話有個現實前提:你要管得動 AI,基本盤還是要讀得懂 code、看得出異常、知道什麼是壞味道(code smell)、懂基本的設計、測試、部署。不然就會變成在「相信 AI」vs「更相信 AI」之間做選擇,而不是「判斷它到底對不對」。
如果有人解讀成「那我就不用學那麼扎實的 coding 了,反正以後 AI 會寫」,那就會悲劇。比較健康的理解是:學 code 的目的,從「自己一行一行刻」變成「能快速理解、重構、組合、把關」。
不要害怕 AI,把它當成一個很會寫 code 但需要你指導的 Junior 就好。未來的決勝點在於:你能不能駕馭 AI,幫你寫出高品質的系統。
這場演講的核心訊息是:AI 是強大的工具,但工具需要人來駕馭。
Vibe Coding 的問題不在於用 AI,而在於「無腦地用」。當我們建立好 Interface、Design Token、Rules 檔案這些 Context,AI 的產出品質會大幅提升。
前端沒有死,死掉的是舊的開發模式。
我常跟團隊說,雖然 AI 幫我們寫 code,但每一次 Commit, PR 都是自己的名字在背書,當 Git Blame 被靠北的時候躲也躲不掉。
業界在談 Responsible AI,講的是倫理、公平、透明。但對我們開發者來說,「負責任地使用 AI」更實際的意思是:AI 幫你寫,你為它的產出買單。 不是不用,而是要用得明白、用得有把握,對最終上線的每一行 code 負責。
從前的前端,我們會強調我們是「橋接設計與後端的拱心石」,現在的前端有了 AI 的幫助,前端的價值早就不只是「把頁面刻出來」而已。 當我們把效能做到極致,使用者留存就會提高;當我們用動畫、視覺化、沉浸式體驗串聯情緒,使用者對品牌的記憶就會更深;當我們讓 AI 與產品互動自然融合,整個產品就會打開新的成長空間。
現在的前端生態,有框架、有工具、有 AI 輔助,從 idea 發想到上線可以快到不可思議。 如果你想深入創新,有 Edge Runtime、有 Streaming UI、有 AI 原生架構,讓你在未知領域挖掘自己的金礦。
我認為 AI 與前端的交會點,就是未來最大的機會。
這是我們與 AI 共存的最好時代,也是最考驗架構能力的時代。
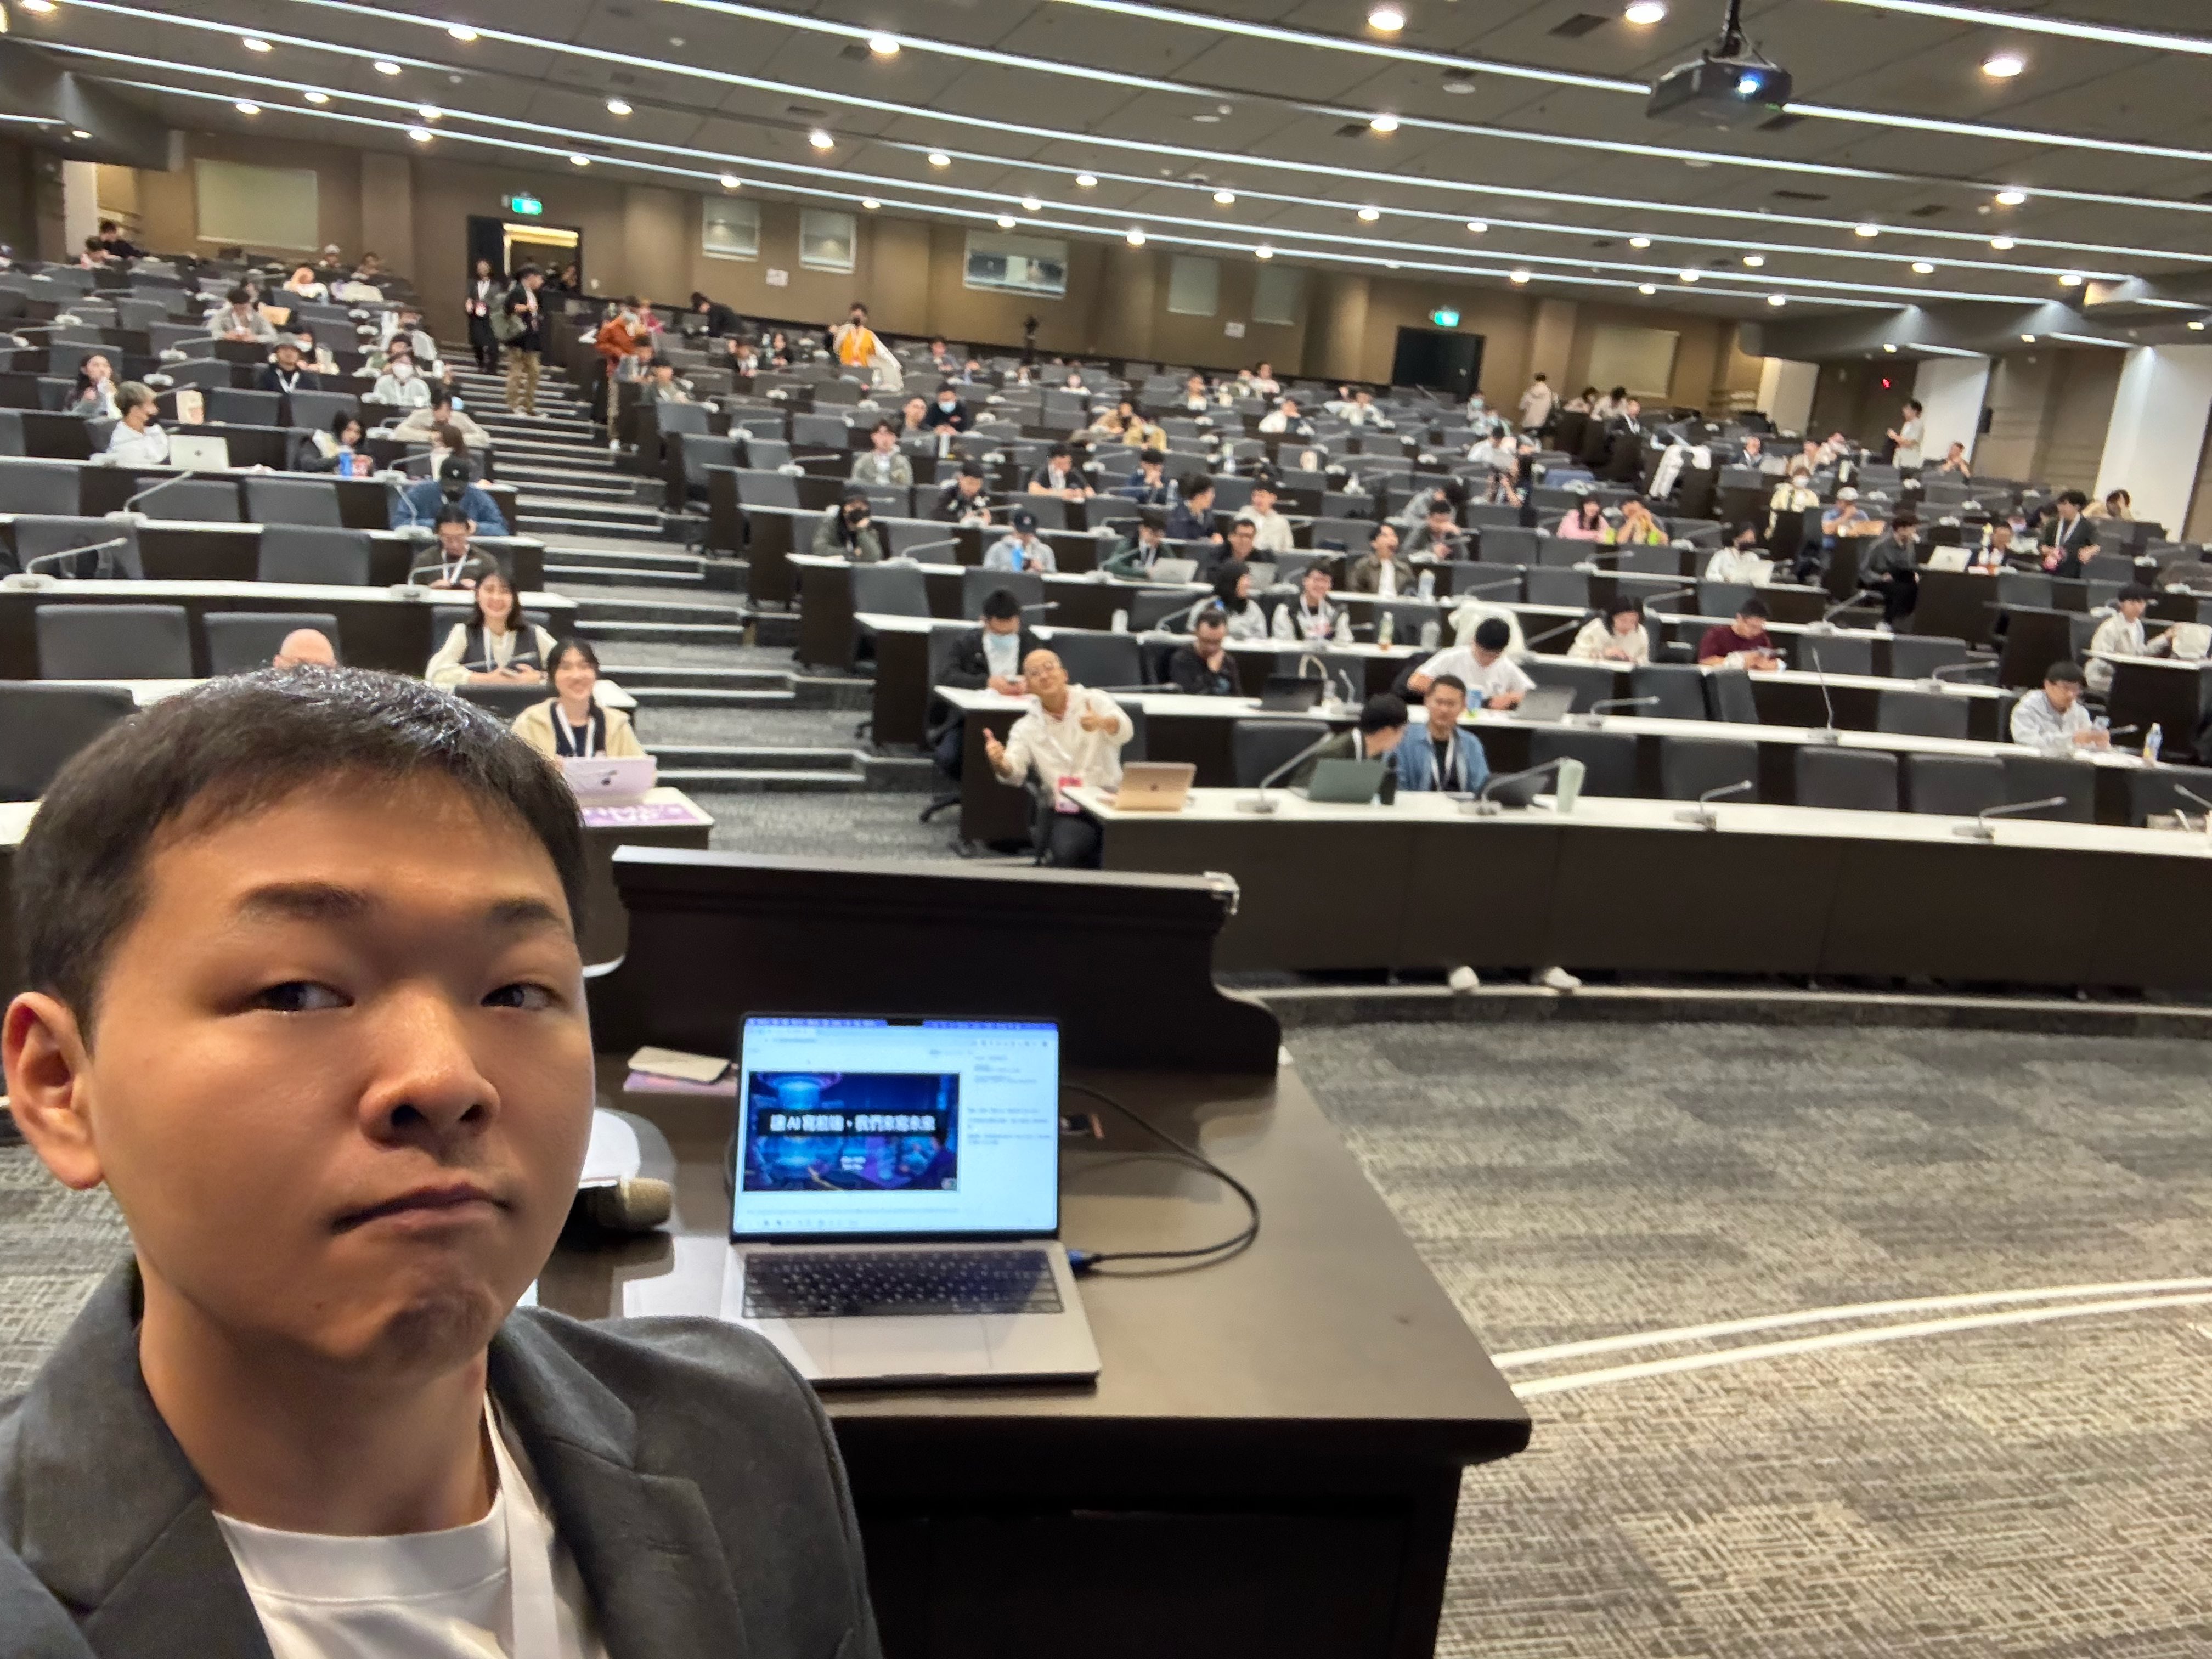
感謝 JSDC 2025 的邀請,以及現場所有參與的會眾。期待明年再見!
簡報連結:
最後預告一下
12 月我在 WebConf 2025 也有一場 「AI 只懂 React?Vue.js 也能 Vibe Coding!」的演講,這場的內容預計會是這場的延伸,更聚焦在實務上 Vue.js 生態系如何與 AI 協作,以及 Vue.js 開發者該注意的 AI 陷阱,歡迎有興趣的朋友來聽!
然後再預告一下 😏